
ปัจจุบันในโลกของการทำงาน ข้อมูลที่ได้รับมาไม่เคยสวยหรู ยิ่งกับประเทศไทยที่ยังต้องมีการพัฒนา ในเรื่องของการเก็บของมูลขนาดใหญ่ (Big Data) ทั้งจากภาครัฐและเอกชน การจะนำไปต่อยอดเพื่อส่งต่อให้ทีมอื่น ๆ ได้ใช้งาน จึงเป็นโจทย์ที่สร้างอุปสรรคมาก
NLP ย่อมาจาก Natural Language Processing มันคืออีกศาสตร์หนึ่งของ Computer science ที่ว่าด้วยการทำให้คอมพิวเตอร์นั้นมีความสามารถในการเข้าใจภาษาจากข้อความหรือคำพูด เฉกเช่นเดียวกันกับที่มนุษย์เข้าใจ
จากประสบการณ์ที่ไหมทำงานเป็น Machine Learning Engineer ในโปรเจคด้าน NLP มา บทความนี้เลยจะมาเล่าถึง ประสบการณ์ (ความยากลำบาก) ที่พบเจอมาในแต่ละโปรเจกต์ NLP ที่ขึ้นอยู่กับโจทย์ กับปัญหาเรื่องของการ clean ข้อมูล
เพื่อให้ทุกท่านที่เข้ามาอ่านบทความนี้สามารถนำไปใช้แก้ปัญหาที่พบในโปรเจค NLP ต่อได้ ทั้งในแง่ของการวิเคราะห์ หรือการนำไปประยุกต์เป็นโมเดลก็ตาม
ปัญหาด้าน ML Engineer ที่พบบ่อยของโปรเจกต์ Machine Learning ด้าน NLP
โจทย์เรื่องภาษานั้น สำหรับภาษาไทยถึงแม้จะมี library และ community แล้วบ้างแต่อย่างไรก็ตาม ภาษาไทยยังเป็นภาษาที่ยังไม่ตาย การเกิดศัพท์ใหม่และวิธีการสื่อสาร จึงเป็นเรื่องที่ยากและท้าทาย ปัญหาที่เกิดขึ้นได้บ่อย ๆ เช่น
- ความพลิกแพลงของภาษา – เช่น ภาษากระเทย ภาษาชายแท้ ที่ความหมายของภาษานั้นเหมือนกัน แต่คำที่ใช้ในการสื่อสารนั้นแตกต่างกัน และขึ้นอยู่กับบริบทและผู้สื่อสารอีกต่างหาก
- วิธีการพิมพ์เพื่อสื่ออารมณ์ – ในภาษาอังกฤษ มีการใช้ตัวอักษรพิมพ์ใหญ่เพื่อสื่อถึงการตะโกน การเน้นเสียง ภาษาไทยก็มีเช่นกัน โดยการใช้เว้นวรรคระหว่างตัวอักษร จึงเกิดความท้าทายให้การ clean ข้อความ เพื่อให้สามารถนำไปใช้ต่อได้ นอกจากนี้การพิมพ์ตัวอักษรซ้ำก็เป็นการลากเสียงอีกต่างหาก แล้วการ clean ข้อมูลต้องแยกให้ออกระหว่าง ข้อความนั้นเป็นการลากเสียง หรือ ตัวอักษรนั้นมีการสะกดด้วยตัวอักษรซ้ำอยู่แล้ว อีก
- ภาษาเอเลี่ยน – ปัญหานี้เกิดจาก Save File ผิด Format ทำให้ภาษาบางภาษาไม่สามารถแสดงผลได้ แต่ปัญหานี้แก้ได้ไม่ยาก ถ้าเรารู้ว่ามันสามารถใช้ Format ไหนได้ถูกต้อง
นอกจากนี้ ยังมีปัญหาของการตัดคำ การตัดประโยค ของภาษาไทยที่อยู่ในกระบวนการการเตรียมความพร้อมของข้อมูล ที่มีความซับซ้อนมากกว่าภาษาอังกฤษที่สามารถใช้การเว้นวรรค และเครื่องหมายจุดเพื่อจบประโยค ทำให้โจทย์ปัญหานี้กลายเป็นเรื่องที่ใช้เวลานานมาก ๆ กว่าจะได้ข้อมูลที่สามารถนำไปใช้ต่อได้
วิธีแก้ปัญหาสำหรับโปรเจกต์ Natural Language Processing (NLP)
เนื่องจากปัญหาของทำความสะอาดข้อมูลที่เป็น NLP จะขึ้นอยู่กับภาษา ดังนั้นในบทความนี้จะขอเจาะจงไปที่การแก้ปัญหาของภาษาไทย
วิธีแก้ปัญหาความซับซ้อนและการพลิกแพลงของภาษาไทย ในโปรเจกต์ NLP
สำหรับปัญหาแบบนี้ การแก้ไขสามารถจัดการได้ตั้งแต่ การ scope context ของโจทย์
หากโจทย์นั้น ๆ ทำอยู่บนบริบทของการแพทย์ คำที่เกี่ยวข้องเราสามารถตีกรอบได้ว่าความหมายของมันจะมีความหมายทางการแพทย์เท่านั้น
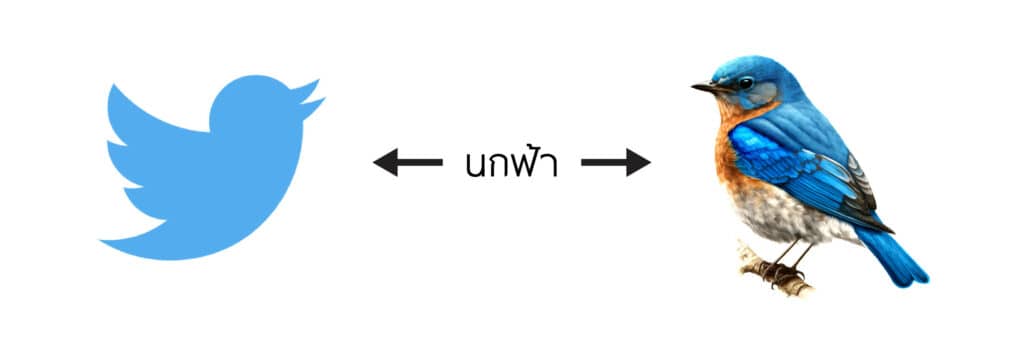
หรือ หากคำนั้นเป็นคำที่มาจาก social media ก็มักจะมีบริบทที่เกี่ยวกับเรื่องนั้น ๆ เช่นคำว่า “นกฟ้า” สามารถแปลได้หลายความหมาย
- ถ้าคำนี้อยู่ในบริบทของสิ่งมีชีวิต เราอาจจะได้ความหมายว่า นกที่มีสีฟ้า
- แต่หากบริบทนั้นคือ social media นกฟ้าจะสื่อถึง “ทวิตเตอร์” (Twitter) ซึ่งนกสีฟ้าเป็นไอคอนของ social media ชื่อดังนั่นเอง
จริง ๆ แล้วปัญหาที่สามารถเกิดได้อีก คือ การพัฒนาของคำบางคำที่เปลี่ยนความหมายไปตามกาลเวลา ทำให้มีความหมายที่ไม่เหมือนแต่ก่อน เช่น “ฉีดยา”หากคำนี้อยู่ในบริบทของการสนทนาของ LGBT+ เราอาจจะได้ความหมายอีกแบบ ที่เกิดจากการพัฒนาทางภาษา
วิธีแก้ปัญหาการสื่ออารมณ์ผ่านทางข้อความ ในโปรเจกต์ NLP
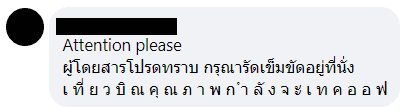
การทำความสะอาดคำเหล่านี้ สามารถเกิดบนภาษาไทยได้จากการเว้นวรรคตัวอักษร เช่น “ห อ ม” หรือ “คุ ณ ภ า พ”
วิธีการที่ง่ายที่สุดคือ การลบเว้นวรรคออก แต่การทำเช่นนี้ ก็จะทำให้เกิดปัญหาถัดมา หากเราต้องการตัดประโยค แล้วหากประโยคนั้น ๆ ไม่ได้ใช้ การขึ้นบรรทัดใหม่ ในการแบ่งประโยคแต่เป็นเว้นวรรค เช่น “ห้ามตัวเองไม่ให้รักเธอ แต่ทำไมใจมันไม่ฟัง” ก็จะสร้างความซับซ้อนในการทำความสะอาดข้อมูลด้วยเช่นกัน
ดังนั้นในการแก้ไขปัญหาโจทย์นี้ เราควรสำรวจข้อมูลและโจทย์ของเราเช่นกันว่า ต้องการการตัดประโยคหรือไม่ และมีการเว้นวรรคเพื่อสื่อถึงอารมณ์เยอะแค่ไหน และแบบใดมันคุ้มค่าต่อการทำความสะอาดหรือตัดทิ้งมากกว่ากัน
ตัวอย่างเช่น “พอเห็นแล้วรู้สึก เ ก เ ร ต่อพรี่ ๆ ห้ามใจตัวเองไม่ให้รักเธอ แต่ทำไมใจมันไม่ฟัง” เป็นต้น จากตัวอย่างจะเห็นได้ว่า หากเลือกตัดประโยคโดยใช้การเว้นวรรค เราจะเสียคำว่า “เกเร” แต่ถ้าเราไม่ใช้การเว้นวรรคในการตัดประโยค ก็จะทำให้ไม่สามารถกำหนดประโยคหนึ่งประโยคได้
ซึ่งจากตัวอย่างข้างต้น วิธีการแก้เราอาจจะต้องทบทวนโจทย์หลักดี ๆ ว่าโจทย์ของเรานั้นคือการตัดประโยคหรือการตัดคำ หรือทั้งสองอย่าง รวมถึง Business Logic และปลายทางของคำตอบที่ต้องการเป็นเช่นไร
หากปลายทางคือการตัดคำ การลบตัวเว้นวรรคก็ไม่ใช่ปัญหา แต่หากปลายทางเป็นการตัดประโยค คำว่า “เ ก เ ร” ก็อาจจะหายไปได้
หรือจริง ๆ เราสามารถใช้ Regex ในการพิจารณา Pattern ที่เกิดขึ้นแล้วทำความสะอาดก่อนก็ได้เช่นกัน แต่อย่าลืมที่จะพิจารณาเรื่องของเวลาที่เราใช้ในการทำความสะอาดกันด้วยนะคะ ดังนั้นการทบทวนโจทย์จึงเป็นสิ่งสำคัญที่ต้องมาพร้อมกับการแก้ปัญหาค่ะ
วิธีแก้ปัญหาภาษาเอเลี่ยน ในโปรเจกต์ NLP
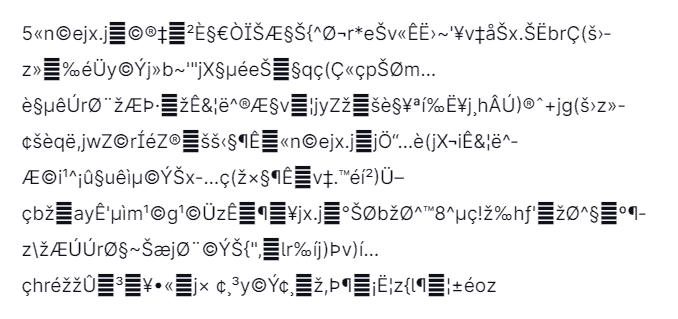
ภาษาเอเลี่ยนหลัก ๆ จะมีปัญหากับภาษาไทย เมื่อเรา import หรือ export โดยไม่สนใจ การ encoding ของมัน บางคนอาจจะเคยตัวอักษรของเรานั้นกลายเป็น Unicode ทำให้ต้องมีการ decode เพื่อให้กลายเป็นตัวอักษรภาษาไทย
นอกจากนี้ บางทีบางไฟล์อาจจะมีการใช้ตัว encode อื่น ๆ (ดูเพิ่มเติมได้ที่ เว็บไซต์ของ Python) ที่ขึ้นอยู่กับภาษา แต่ถ้าโดยปกติแล้วก็จะใช้ UTF-8 ซึ่งหากเราบันทึกเป็นแบบนี้อยู่แล้วส่วนมากก็จะไม่มีปัญหาค่ะ
สรุป วิธีแก้ปัญหาด้าน Machine Learning Engineer ในโปรเจกต์ NLP
ในบทความนี้ ไหมอธิบายวิธีการแก้ปัญหาด้าน ML Engineer กับภาษาไทย ในโปรเจกต์ NLP กันไปแล้ว สามารถนำไปใช้แก้ปัญหาในโปรเจกต์ NLP ของคุณได้เลย
หรือถ้าใครสนใจจะเริ่มทำโปรเจกต์ด้าน NLP ภาษาไทย อย่าลืมเอาวิธีต่าง ๆ เหล่านี้ไปใช้ เพื่อป้องกันไม่ให้เกิดปัญหานะคะ
ถ้าชอบเนื้อหาแนวนี้ ช่วยแชร์กันได้นะคะ ไหมจะได้มาเขียนเล่าบ่อย ๆ ค่ะติดตามบทความดี ๆ ด้าน Data และวีดิโอสนุก ๆ ดูชิล ๆ แล้วได้ความรู้กันได้ที่ Facebook Page: DataTH และ Youtube Channel: Data Science ชิลชิล แล้วเจอกันค่ะ